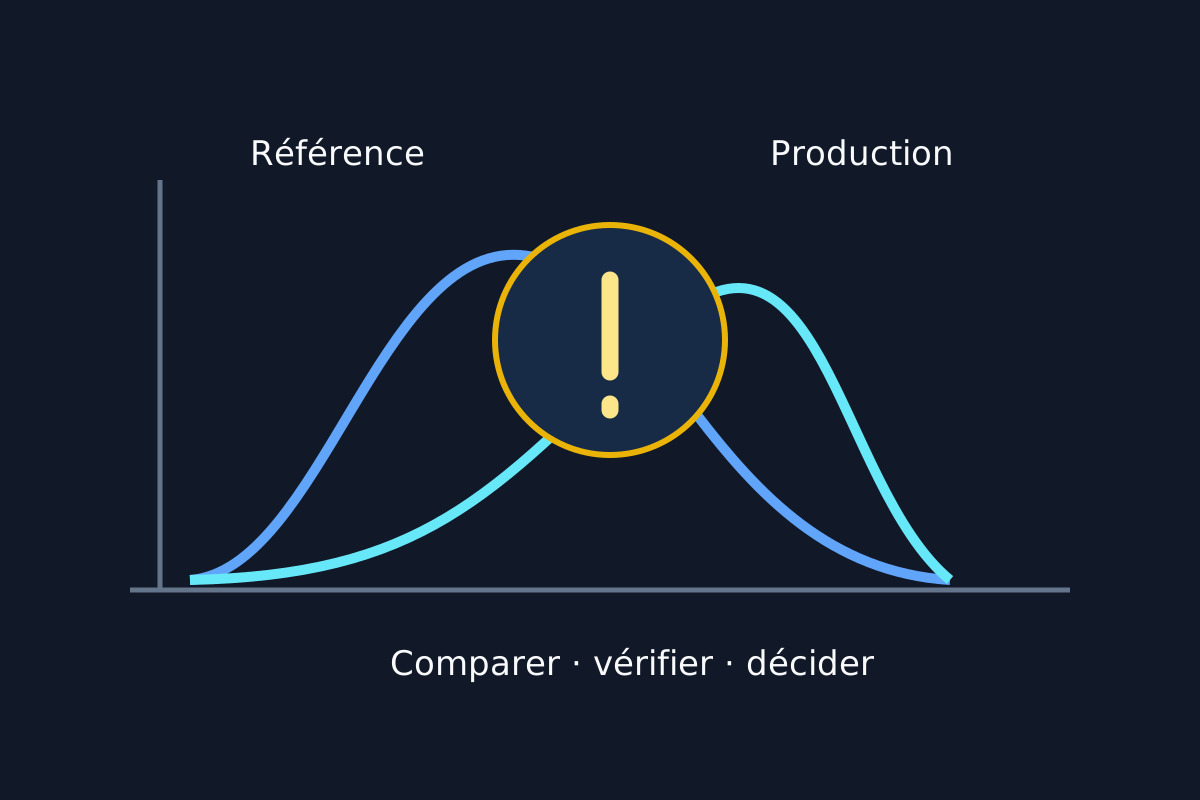
Dérive d'un modèle de machine learning : détecter et agir
Un guide pour distinguer les changements normaux des signaux qui imposent une enquête ou une nouvelle évaluation.
Retrouvez les articles publiés dans cette thématique.
Un guide pour distinguer les changements normaux des signaux qui imposent une enquête ou une nouvelle évaluation.
Comprendre les erreurs de classification avec un exemple chiffré et choisir une métrique adaptée à la décision.
Repérer les informations indisponibles au moment de prédire et séparer correctement entraînement, validation et test.
Conserver les données, le code, les paramètres et les résultats nécessaires pour reprendre une expérience sans ambiguïté.

Le feature engineering est l’art de créer des variables (features) qui permettent aux modèles de mieux apprendre. Ce guide couvre les techniques essentielles : encodage, mise à l’échelle, création de combinaisons, gestion des dates, et bonnes pratiques pour améliorer vos performances.

L’analyse exploratoire des données (EDA) est l’étape incontournable avant tout modèle de ML. Ce guide complet couvre les méthodes, visualisations et bonnes pratiques en Python (pandas, seaborn) et R (tidyverse, ggplot2).

Tous les LLM ne se valent pas pour la data science. Comparatif des modèles (GPT-5, Gemini 2.5 Pro, Claude 4, Llama 3) sur Python, SQL, analyse statistique. Lequel choisir en 2026 ?
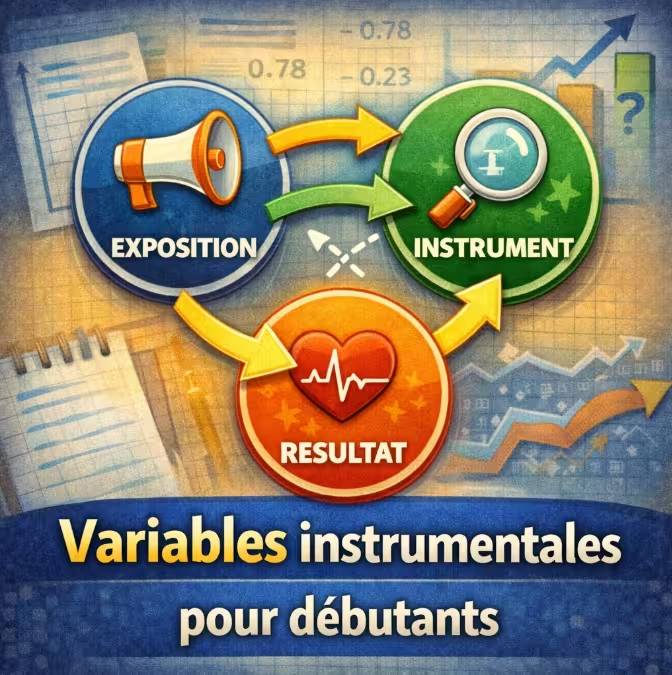
Une variable instrumentale (ou instrument) est une variable qui permet de contourner les biais dans l'estimation d'un effet causal, en particulier quand on soupçonne l'existence de variables confondantes non observées.
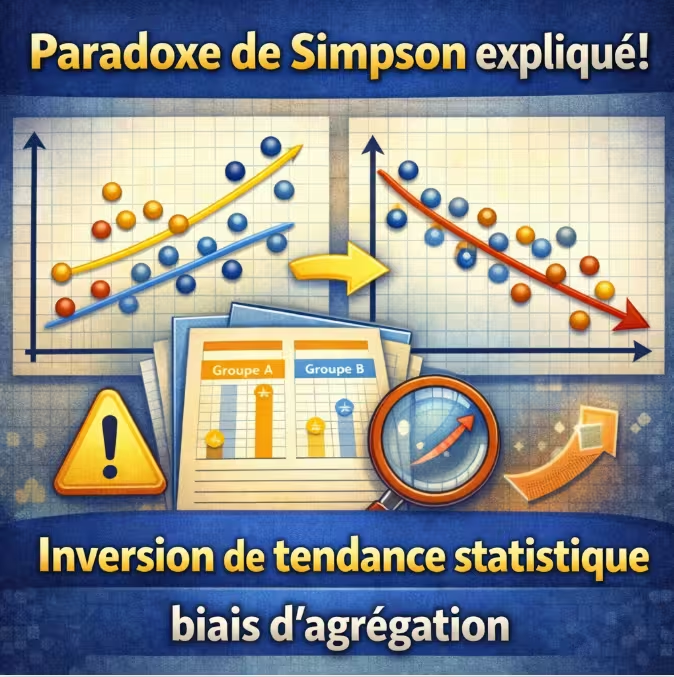
Le paradoxe de Simpson est un phénomène statistique contre-intuitif : une tendance observée dans chaque groupe pris séparément peut s'inverser lorsqu'on regarde les groupes fusionnés.
L'inférence causale est l'ensemble des méthodes statistiques qui permettent de répondre à une question fondamentale : "Cette action a-t-elle vraiment causé ce résultat ?"
Une variable confondante (ou facteur de confusion) est une variable externe qui influence à la fois la cause présumée et l'effet étudié, créant une association trompeuse entre les deux.
La corrélation est une mesure statistique qui quantifie le degré de liaison linéaire entre deux variables. En d'autres termes, elle indique dans quelle mesure deux phénomènes évoluent ensemble.
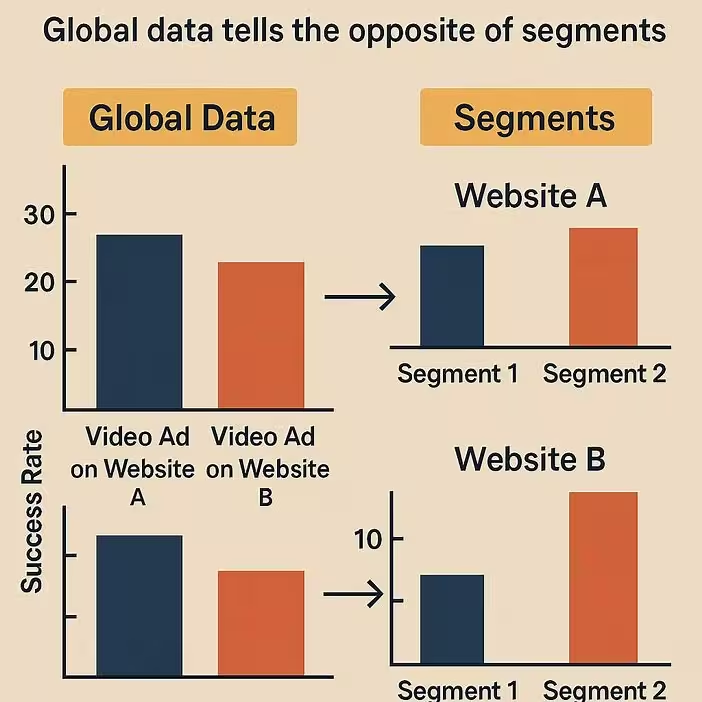
Le paradoxe de Simpson désigne une situation statistique dans laquelle une tendance observée dans plusieurs groupes séparés s’inverse ou disparaît lorsque ces groupes sont fusionnés. Dit autrement, chaque segment raconte
L’inférence causale regroupe un ensemble de méthodes statistiques et économétriques visant à estimer l’effet d’une action, d’un traitement, d’une exposition ou d’une décision sur un résultat donné. Le mot important ici n
Un biais cognitif est une déviation systématique de la pensée, une manière récurrente de simplifier la réalité, parfois utile, souvent trompeuse. Dans un contexte d’analyse de données, ces biais influencent la manière do
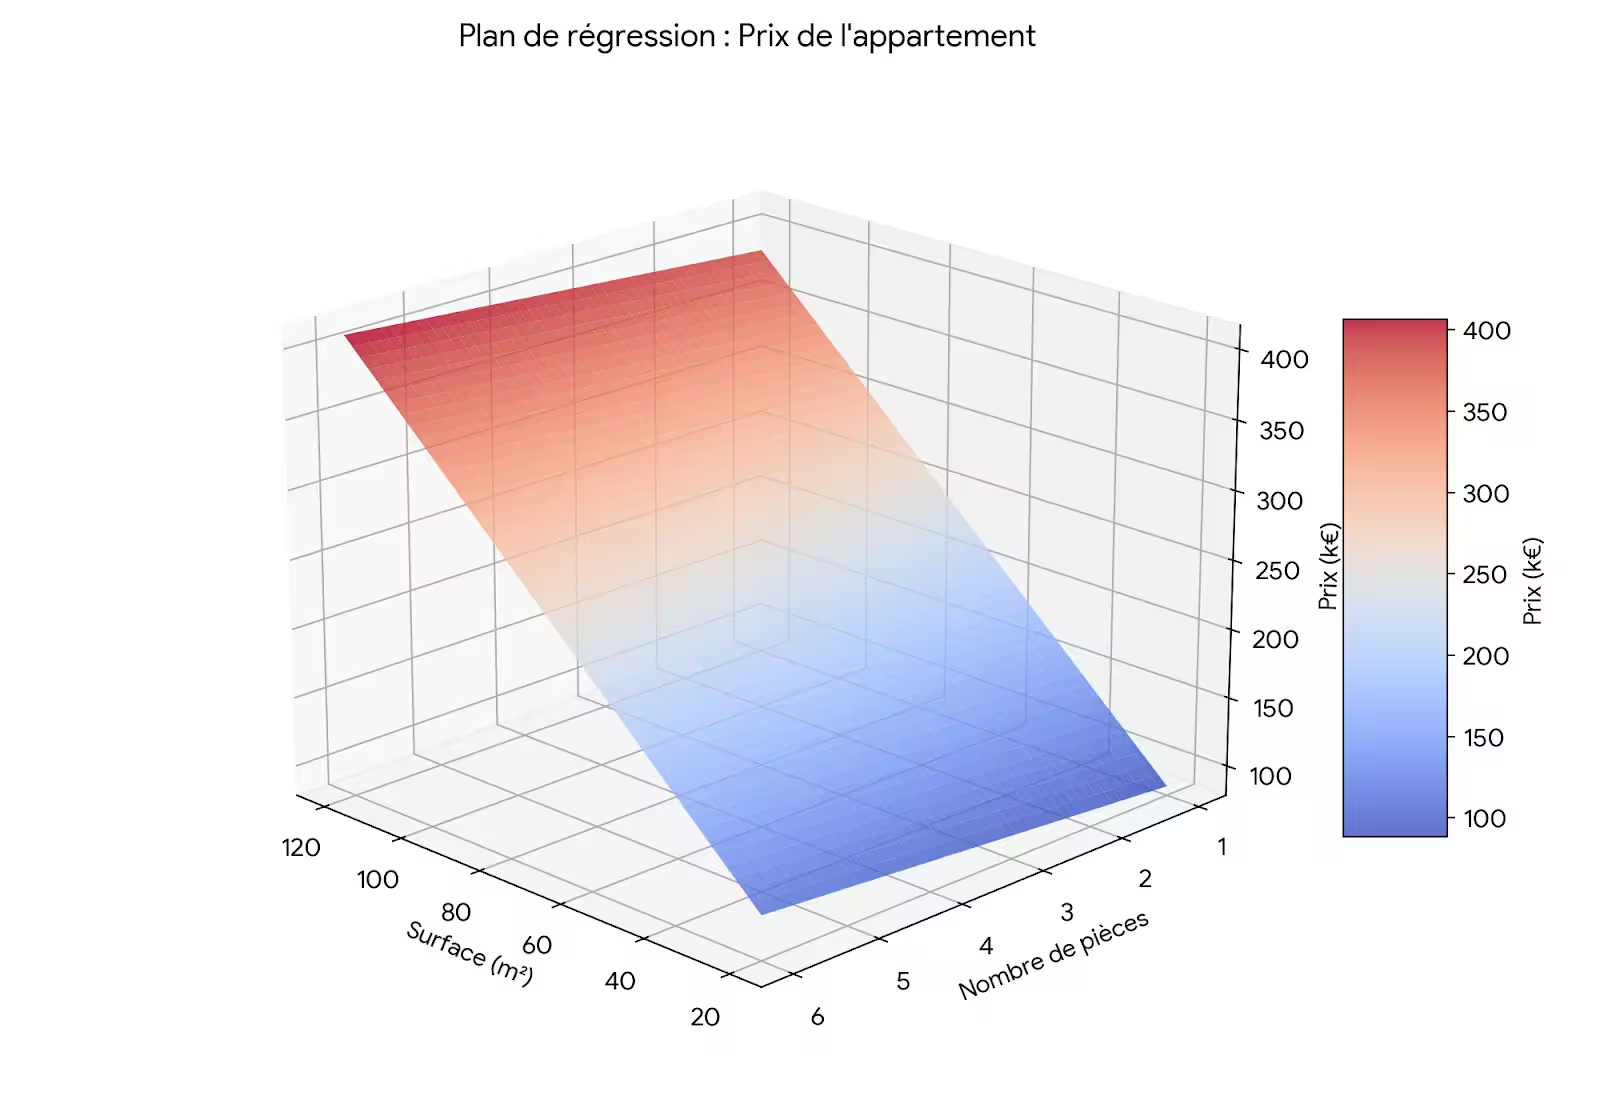
La régression linéaire multiple est une méthode statistique permettant de modéliser la relation entre une variable dépendante et plusieurs variables explicatives. Autrement dit, il ne s’agit plus de comprendre une relati
L’analyse exploratoire des données, souvent appelée EDA (Exploratory Data Analysis), désigne l’ensemble des méthodes permettant d’examiner un jeu de données afin d’en comprendre les caractéristiques principales.
Data Science : méthodes, outils, EDA, régression, biais, corrélation vs causalité. Cas pratiques Python/SQL. Guide complet pour maîtriser l’analyse de données.

Dans le monde de l’analyse des données, distinguer entre corrélation et causalité est crucial pour tirer des conclusions fiables et éviter des erreurs d’interprétation. Les deux notions sont proches dans le langage coura