Un pipeline de données utile ne se limite pas à déplacer des lignes très vite. Il doit lire une source sans saturer la mémoire, transformer les champs de manière contrôlée, écrire des lots cohérents dans MariaDB et reprendre après un incident. L’API qui restitue les résultats doit rester disponible pendant l’import.
Dans une architecture Node.js et Express, un partage simple des rôles aide à éviter les blocages : Node.js orchestre les flux et les traitements d’intégration ; MariaDB conserve les données relationnelles ; Express expose des opérations courtes pour lancer un traitement ou consulter ses résultats. Les longues tâches s’exécutent en arrière-plan, avec un état durable et des règles de reprise.
La documentation Node.js consultée pour cet article est celle de la branche 26.13.0 ; les pages du connecteur MariaDB Node.js et du serveur ont aussi été vérifiées le 5 novembre 2026. Les versions déployées, capacités et options d’hébergement doivent être confirmées pour chaque projet.
ETL et ELT : le lieu de transformation change
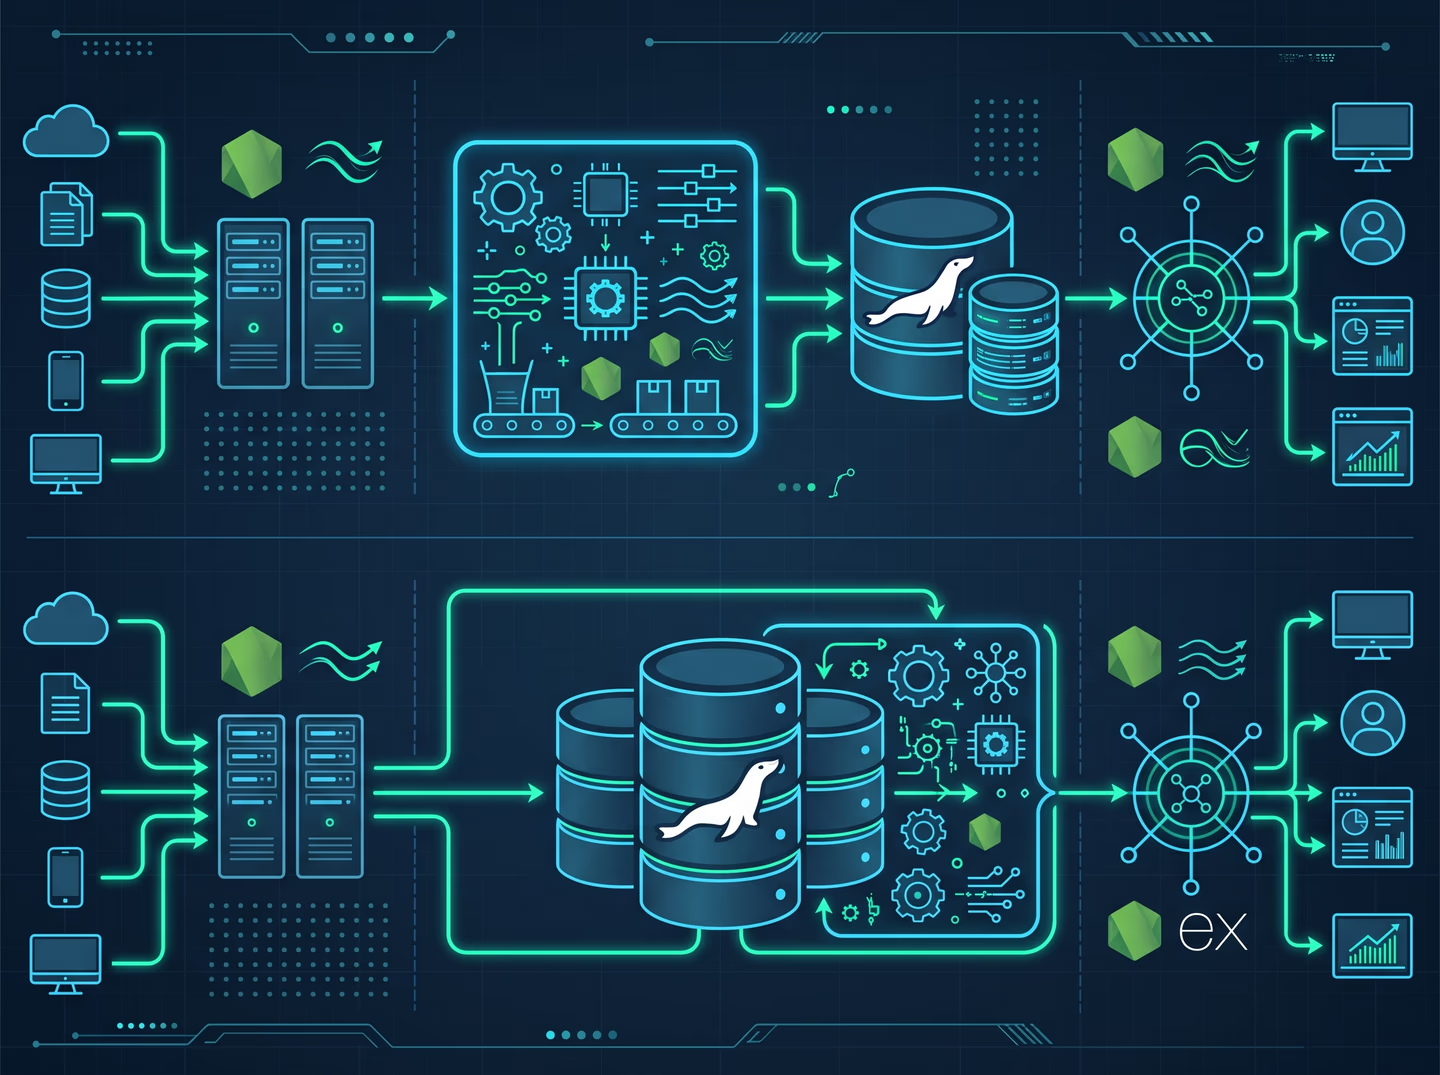
Les deux architectures partagent généralement les mêmes responsabilités : extraire des données d’une ou plusieurs sources, appliquer des règles, conserver un résultat et le rendre accessible aux usages. La différence centrale est l’ordre entre transformation et chargement.
ETL : transformer avant la table cible
ETL signifie Extract, Transform, Load. Un flux est extrait, validé et transformé dans Node.js ou dans un composant intermédiaire, puis inséré dans les tables cibles. Cette approche est utile lorsqu’il faut refuser tôt des lignes invalides, nettoyer les formats avant de les conserver ou isoler une source dont la structure n’est pas stable.
Le pipeline peut convertir les dates vers un fuseau et un format convenus, normaliser les identifiants, vérifier les champs requis, enrichir une référence depuis une petite table et envoyer les lignes rejetées vers un rapport d’erreurs. La table de destination contient ainsi des données préparées selon les règles définies.
En contrepartie, le code de transformation doit être versionné, testé et maintenu. Si plusieurs consommateurs ont besoin de la donnée brute, supprimer cette dernière à l’entrée peut empêcher une nouvelle règle de retraitement. Une zone d’atterrissage immuable ou une archive source peut alors compléter le modèle.
ELT : charger d’abord, transformer dans MariaDB
ELT signifie Extract, Load, Transform. Les lignes extraites sont déposées dans une zone dédiée, puis des requêtes SQL créent les tables et agrégats utilisés par l’application. Cette option rend les données reçues disponibles pour une relecture et permet de tirer parti des transformations relationnelles set-based.
La zone brute ne doit pas devenir un dépotoir sans propriétaire. Ajoutez un identifiant de lot, la source, la date d’ingestion, le numéro de ligne ou l’identifiant source et l’état de validation. Définissez qui peut consulter les données brutes et combien de temps elles sont conservées. Dans MariaDB, prévoyez aussi la capacité nécessaire aux transformations intermédiaires et aux index.
ELT ne signifie pas que le moteur de base exécute automatiquement mieux chaque calcul. Les jointures, tris, agrégats et mises à jour sollicitent les ressources partagées avec l’API. Il faut mesurer la charge sur des données réalistes, puis organiser les lots et fenêtres d’exécution pour préserver les requêtes interactives.
Choisir en fonction du besoin et de l’exploitation
| Question | Indication en faveur de l’ETL | Indication en faveur de l’ELT |
|---|---|---|
| Les formats reçus sont-ils irréguliers ? | Normaliser ou rejeter dans l’étape d’intégration peut clarifier l’entrée. | Une zone brute versionnée facilite une nouvelle transformation. |
| Les règles de qualité sont-elles complexes ? | Les validations peuvent être explicites dans le code avant écriture. | Des contrôles SQL conviennent si le moteur et le schéma rendent les règles lisibles. |
| Faut-il retraiter une source historique ? | Conserver une archive externe et relancer la transformation versionnée. | Rejouer les données depuis la zone brute, en contrôlant stockage et durée de conservation. |
| L’API partage-t-elle la même MariaDB ? | Le traitement Node peut limiter la charge SQL, sans garantir un meilleur débit. | Les transformations dans la base peuvent concurrencer les lectures de l’API. |
| Les équipes savent-elles diagnostiquer les erreurs ? | Les rapports de lignes rejetées doivent être exploitables. | Les étapes SQL et leur état doivent être observables et rejouables. |
Les modèles peuvent être combinés. Par exemple, valider la structure et les droits dans Node.js, charger une table d’atterrissage, puis calculer une table de faits en SQL. Notre guide des pipelines ETL/ELT et de l’orchestration présente les concepts à un niveau plus général.
Séparer l’API Express du travail long
Express convient à des routes qui valident une demande, vérifient un droit, planifient un traitement, consultent un état ou livrent une page de résultats. Il ne faut pas forcément lire et transformer un fichier volumineux au cours de la même requête HTTP. Un import peut durer plus longtemps qu’un délai d’attente réseau, être interrompu lors d’un redémarrage ou consommer suffisamment de CPU pour dégrader les autres requêtes.
Un parcours robuste peut être : la route POST /imports vérifie le fichier et les options, crée un identifiant de travail en base puis renvoie 202 Accepted avec cet identifiant. Un worker séparé récupère le travail et traite la source. La route GET /imports/:id expose son état et quelques compteurs. L’utilisateur peut ensuite consulter les résultats transformés par une route de lecture paginée.
Ce découpage sépare l’interface de lancement et l’exécution. Il permet de redémarrer un worker sans perdre l’état du travail, de limiter le nombre de traitements concurrents et de faire évoluer le système vers une file ou un orchestrateur si la demande l’exige. Le guide Express sur les performances et la fiabilité en production rappelle également qu’un calcul intensif exécuté sur le thread JavaScript peut ralentir les autres requêtes. Si une transformation est fortement CPU, mesurez-la et envisagez un worker thread ou un processus de travail dédié.
Lire un flux sans charger tout le fichier
Un appel qui fait await readFile(path) puis JSON.parse() d’un grand fichier peut garder le contenu entier en mémoire, parfois en plusieurs représentations simultanées. Les streams permettent de traiter les données progressivement. La documentation Node.js sur les streams décrit la contre-pression : lorsqu’un consommateur ralentit, le producteur peut être freiné au lieu d’alimenter indéfiniment sa file.
Le code suivant illustre la lecture d’un fichier NDJSON (un objet JSON par ligne), une normalisation puis des écritures par lots. Il utilise les modules intégrés de Node.js et le connecteur MariaDB ; un flux CSV exige en plus un parseur CSV qui respecte les guillemets et les retours à la ligne intégrés aux champs.
import { createReadStream } from "node:fs";
import { createInterface } from "node:readline";
import { Readable } from "node:stream";
import { pipeline } from "node:stream/promises";
import mariadb from "mariadb";
import { MariaBatchWriter } from "./MariaBatchWriter.js";

const pool = mariadb.createPool({
  host: process.env.DB_HOST,
  user: process.env.DB_USER,
  password: process.env.DB_PASSWORD,
  database: process.env.DB_NAME,
  connectionLimit: 5, // Valeur de démonstration à ajuster par mesure.
});

async function* readOrders(filePath) {
  const lines = createInterface({
    input: createReadStream(filePath),
    crlfDelay: Infinity,
  });

  for await (const line of lines) {
    if (!line.trim()) continue;

    const raw = JSON.parse(line);
    const occurredAt = new Date(raw.occurredAt);

    if (!raw.id || Number.isNaN(occurredAt.valueOf())) {
      throw new Error("Ligne sans identifiant ou date valide");
    }

    yield {
      sourceId: String(raw.id),
      customerSourceId: String(raw.customerId),
      amountCents: Number(raw.amountCents),
      occurredAt,
    };
  }
}

try {
  await pipeline(
    Readable.from(readOrders("./imports/orders.ndjson"), { objectMode: true }),
    new MariaBatchWriter(pool, { batchSize: 250 }),
  );
} finally {
  await pool.end();
}
MariaBatchWriter est une écriture objet qui accumule au plus un lot, appelle persistBatch() puis n’appelle le rappel d’écriture qu’après la fin de l’opération. Lorsqu’un lot atteint sa taille, le flux attend l’écriture en base : c’est cette attente qui laisse la contre-pression ralentir la lecture. À la fin, la méthode _final() vide le dernier lot incomplet. Son implémentation complète dépend des règles de journalisation, de reprise et de checkpoint du projet ; ne remplacez pas ce comportement par une accumulation illimitée dans un tableau.
Le paramètre highWaterMark d’un stream est un seuil de tampon, pas une limite mémoire absolue. La taille des objets, les buffers créés par un parseur, les lots applicatifs et le nombre de workers simultanés comptent aussi. Mesurez la mémoire avec la plus grande ligne attendue, les caractères Unicode, les champs longs et des pointes d’entrée. Notre article sur le streaming de données en temps réel détaille ces compromis.
Écrire en lots dans MariaDB
Une requête INSERT par ligne répète les échanges réseau, la préparation et l’exécution. Le connecteur MariaDB Node.js fournit des méthodes batch dans ses API Promise ; sa documentation indique qu’à partir de MariaDB Server 10.2.7 le connecteur utilise un protocole bulk dédié pour cette opération. Cette capacité ne promet pas un débit identique sur toutes les versions et configurations : mesurez l’effet sur votre environnement (API Promise du connecteur, API Batch).
Une fonction d’écriture peut réserver une connexion, ouvrir une transaction, écrire le lot avec des placeholders, mettre à jour le checkpoint puis valider. En cas d’erreur, elle annule la transaction et rend la connexion au pool.
async function persistBatch(pool, rows) {
  if (rows.length === 0) return;

  const connection = await pool.getConnection();

  try {
    await connection.beginTransaction();

    await connection.batch(
      `INSERT INTO order_fact
        (source_id, customer_source_id, amount_cents, occurred_at)
       VALUES (?, ?, ?, ?)
       ON DUPLICATE KEY UPDATE
         customer_source_id = VALUES(customer_source_id),
         amount_cents = VALUES(amount_cents),
         occurred_at = VALUES(occurred_at)`,
      rows.map((row) => [
        row.sourceId,
        row.customerSourceId,
        row.amountCents,
        row.occurredAt,
      ]),
    );

    // En production, écrire le curseur du lot dans cette même transaction.
    await connection.commit();
  } catch (error) {
    await connection.rollback();
    throw error;
  } finally {
    connection.release();
  }
}
Les placeholders protègent les valeurs ; ils ne remplacent pas la validation métier. La table doit avoir une clé unique qui identifie la ligne source si l’upsert est le mécanisme d’idempotence choisi. MariaDB documente INSERT ... ON DUPLICATE KEY UPDATE comme une mise à jour lorsqu’une clé primaire ou unique existe déjà. La page de référence précise aussi qu’en présence de plusieurs index uniques correspondants, seul le premier est mis à jour et que ce cas n’est pas recommandé : concevez les contraintes avant de compter sur l’upsert (référence MariaDB).
La taille d’un lot doit être déterminée par des mesures. Un lot trop petit multiplie les allers-retours ; un lot trop grand augmente le tampon mémoire, le temps de transaction, les verrous et le coût d’une reprise. Le nombre de colonnes, la taille des champs, le max_allowed_packet, le réseau, les index et la charge concurrente influencent le résultat. Commencez modestement, mesurez la durée p50/p95, le temps des commits et la mémoire, puis augmentez ou réduisez une variable à la fois.
Les transactions groupent l’écriture des lignes et, si possible, le checkpoint correspondant. MariaDB fonctionne par défaut avec l’autocommit ; BEGIN, COMMIT et ROLLBACK permettent de traiter un lot comme une unité logique sur un moteur transactionnel tel qu’InnoDB (transactions MariaDB). Des lots courts limitent la durée des verrous et facilitent le retour à un état cohérent.
Modéliser pour la reprise et la qualité
Une table de faits minimale peut contenir une clé source stable, une clé métier, les mesures, la date métier, la date d’ingestion, l’identifiant du run et la version de transformation. La clé source sert à reconnaître une ligne déjà traitée. L’identifiant de run et la date d’ingestion permettent de diagnostiquer ce qui est arrivé sans confondre le moment d’arrivée et le moment de l’événement.
CREATE TABLE order_fact (
  source_id VARCHAR(128) NOT NULL PRIMARY KEY,
  customer_source_id VARCHAR(128) NOT NULL,
  amount_cents BIGINT NOT NULL,
  occurred_at DATETIME(6) NOT NULL,
  ingested_at DATETIME(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6),
  transform_version VARCHAR(32) NOT NULL
) ENGINE=InnoDB;

CREATE INDEX idx_order_customer_time
  ON order_fact (customer_source_id, occurred_at, source_id);
Cet index est un exemple, pas un conseil universel. Il peut aider une requête qui filtre par client et période, mais il ajoute du travail aux insertions. Examinez les requêtes réelles, leur plan, la sélectivité et les index existants. Évitez les index redondants sur les mêmes préfixes et surveillez les migrations d’index lorsque la table grandit.
La qualité doit être traitée à chaque étape : format de date, valeurs manquantes, doublons, unités, devise, bornes, encodage et cohérence entre champs. La décision de rejeter, corriger ou mettre en quarantaine doit être explicite. Gardez la ligne d’origine ou une référence permettant de la retrouver, sans copier inutilement des données personnelles dans les journaux. Notre guide du contrôle qualité des pipelines fournit une méthode complémentaire.
Reprise, idempotence et checkpoints
Un pipeline qui ne peut pas être rejoué est fragile. Les coupures réseau, arrêts de processus, limites de temps, erreurs de schéma et changements de source font partie de l’exploitation. Concevez l’import pour accepter une relecture sans produire de doublons ni écraser des données plus récentes par une ancienne version.
Une clé source stable rend une partie de la reprise possible. Un upsert peut remplacer l’état courant d’un enregistrement, si la règle de priorité est clairement définie. Pour des événements qui doivent être conservés individuellement, la clé de déduplication inclut souvent l’identifiant d’événement plutôt qu’un identifiant d’entité. Ne masquez pas toutes les erreurs avec INSERT IGNORE : cela peut transformer un incident de qualité ou de contrainte en perte silencieuse.
Un checkpoint enregistre le dernier élément entièrement validé, par exemple un couple (updated_at, source_id) ordonné. Mettre à jour le checkpoint dans la même transaction que le lot évite de déclarer un lot terminé alors que ses lignes n’ont pas été écrites. Si la source fournit une pagination ou un curseur, utilisez son contrat plutôt qu’un maximum arbitraire calculé depuis la cible. En cas d’échec avant le commit, relisez le lot ; si l’écriture est idempotente, cette relecture est maîtrisable.
La stratégie de retry doit distinguer les erreurs transitoires des erreurs permanentes. Une indisponibilité réseau peut justifier une nouvelle tentative avec délai progressif et jitter. Une colonne invalide ou une violation de règle ne sera pas réparée par une répétition immédiate. Après plusieurs échecs, stockez le lot ou les lignes rejetées dans une zone de quarantaine et rendez l’incident visible.
Restituer les données avec une API mesurable
Une API Express ne devrait pas exposer toutes les lignes d’une table d’un seul coup. Définissez la période, le périmètre autorisé, la projection des colonnes et une pagination. Pour des tables volumineuses, une pagination par curseur stable est souvent plus prévisible qu’un OFFSET croissant, mais le bon choix dépend de l’usage et des index.
Exemple de requête parametrée côté connecteur :
app.get("/api/orders", async (req, res, next) => {
  try {
    const customerId = req.auth.customerId;
    const limit = Math.min(Number(req.query.limit) || 50, 200);
    const from = parseDate(req.query.from);

    const rows = await pool.query(
      `SELECT source_id, amount_cents, occurred_at
       FROM order_fact
       WHERE customer_source_id = ? AND occurred_at >= ?
       ORDER BY occurred_at DESC, source_id DESC
       LIMIT ?`,
      [customerId, from, limit],
    );

    res.json({ data: rows });
  } catch (error) {
    next(error);
  }
});
parseDate doit rejeter les dates invalides et l’identité du client doit provenir d’un contexte authentifié, non d’un paramètre libre. Les noms de colonnes, direction de tri et noms de tables ne sont généralement pas des valeurs SQL paramétrables : si l’API propose un tri, mappez les choix autorisés vers une liste fixe. Un paramètre LIMIT doit être borné par une valeur maximale définie par le service.
Un index doit correspondre aux filtres et à l’ordre de la route, puis être vérifié avec EXPLAIN et des données représentatives. Ne créez pas un index pour chaque filtre imaginable : chaque index augmente les coûts d’écriture et de maintenance. Si une réponse doit agréger un historique complet, préparez éventuellement une table de synthèse mise à jour par le pipeline plutôt que de recalculer une agrégation lourde pour chaque visite.
Connexions, secrets et exploitation
Un pool évite d’ouvrir une nouvelle connexion pour chaque requête, mais une limite arbitraire peut elle-même saturer le serveur. Additionnez les connexions possibles de chaque instance Express, worker, console d’administration et outil de maintenance. Ajustez le pool après mesure de la concurrence et des files d’attente ; libérez toujours les connexions acquises et fermez le pool lors de l’arrêt du processus. L’API Promise du connecteur MariaDB documente getConnection(), beginTransaction(), batch(), commit(), rollback() et release().
Les secrets ne doivent pas être commis avec le code. Utilisez la configuration de l’environnement de déploiement ou un gestionnaire de secrets ; limitez les droits du compte de pipeline aux tables et opérations nécessaires. Évitez de renvoyer les erreurs SQL brutes à l’utilisateur. Les journaux opérationnels devraient privilégier l’identifiant de job, la source, le nombre de lignes, le temps, le checkpoint et le type d’erreur plutôt que le contenu complet de chaque enregistrement.
Suivez au minimum le retard par rapport à la source, le nombre lu/transformé/chargé/rejeté, la durée de chaque étape, la taille des lots, les retries, l’usage mémoire, la file de travaux et le temps de réponse des routes de lecture. La surveillance du seul temps moyen cache les valeurs extrêmes ; regardez les percentiles et comparez-les aux objectifs du service. Conservez un échantillon de lignes invalides avec un accès restreint afin de corriger les règles sans recopier inutilement tout le jeu de données.
Une mise en place progressive en dix étapes
- Décrire la source, sa fréquence, son contrat, ses limites et les usages de restitution.
- Définir le schéma d’arrivée, la clé d’idempotence et les règles de rejet.
- Choisir ETL, ELT ou une combinaison selon la charge et les capacités réelles.
- Prototyper sur un échantillon couvrant doublons, valeurs absentes et lignes volumineuses.
- Construire la lecture en flux et faire remonter les erreurs jusqu’au pipeline.
- Choisir une taille de lot de départ, puis mesurer avant de l’augmenter.
- Écrire les lignes et le checkpoint dans des transactions courtes.
- Vérifier les index avec les principales requêtes de restitution.
- Exposer le lancement et l’état du traitement indépendamment de l’import long.
- Tester reprise, relecture, permissions, arrêt, données invalides et capacité de retour arrière.
Ce parcours fonctionne pour un prototype comme pour une intégration déjà utilisée, à condition d’ajouter les contraintes propres à la source et à l’hébergement. Si les événements arrivent continuellement et que la fraîcheur est déterminante, comparez l’approche avec les architectures abordées dans notre guide sur les pipelines de données et l’orchestration.
FAQ : Node.js, Express, MariaDB et les pipelines
Quelle différence entre ETL et ELT ?
ETL transforme les données avant leur chargement dans la table cible ; ELT les charge d’abord dans une zone d’atterrissage et effectue ensuite la transformation avec le moteur cible. Une architecture peut combiner les deux : validation et contrôle des droits dans Node.js, transformation relationnelle dans MariaDB.
Pourquoi utiliser des streams Node.js ?
Ils permettent de traiter un flux progressivement et d’appliquer une contre-pression lorsque l’étape suivante ralentit. Ils sont utiles pour éviter de charger un fichier entier en mémoire, mais le seuil de tampon n’est pas une limite mémoire stricte. Les parseurs, objets, lots et traitements CPU doivent aussi être surveillés.
Quelle taille de batch choisir ?
Il n’existe pas de valeur valable pour toutes les tables. Commencez avec un lot modeste, mesurez la latence d’écriture, le temps de commit, les verrous, la mémoire et les limites de paquet, puis ajustez. Un lot plus grand ne garantit pas un meilleur temps de bout en bout.
Un import doit-il s’exécuter dans une route Express ?
Une route peut accepter la demande, créer un travail et fournir un identifiant de suivi. Un worker séparé réalise l’import afin que la requête HTTP se termine rapidement et que le traitement soit redémarrable. Le job doit enregistrer son état et son checkpoint.
Comment relancer un job sans doublons ?
Utilisez une clé source stable et une écriture idempotente, validez chaque lot dans une transaction et enregistrez le checkpoint après l’écriture, idéalement dans la même transaction. Une relecture doit pouvoir répéter les données déjà vues sans créer un second enregistrement.
Cette architecture convient-elle à tous les volumes ?
Non. Node.js, Express et MariaDB peuvent bien répondre à un pipeline maîtrisé et proche des données relationnelles d’une application. La charge CPU, le débit de la source, la concurrence et la profondeur des transformations peuvent justifier un worker distribué, un orchestrateur ou une plateforme analytique différente. Mesurez avant de conclure.
Conclusion : optimiser la chaîne entière
Un pipeline efficace ne se juge pas seulement à la vitesse d’un INSERT. Il doit préserver la mémoire, appliquer une contre-pression, valider les règles, écrire des lots cohérents, reprendre sans doublons et alimenter des requêtes utiles. Express assure l’interface de service ; un worker prend en charge le travail long ; MariaDB stocke et interroge les tables selon un schéma et des index vérifiés.
Commencez avec un flux représentatif, un lot mesuré, une clé idempotente et un checkpoint explicite. Étendez ensuite la capacité à partir des métriques, en gardant les transformations et règles métier testables. Pour approfondir les étapes de contrôle avant et après le chargement, consultez le guide de contrôle qualité des pipelines de données.