En 2026, une équipe qui relie un grand modèle de langage à ses documents doit souvent choisir entre deux familles de solutions : le RAG (génération augmentée par recherche) et le fine-tuning (ajustement fin du modèle). Les deux modifient l’expérience d’un assistant, mais pas de la même manière. Le RAG cherche des informations externes au moment de répondre. Le fine-tuning modifie les paramètres du modèle à partir d’exemples d’entraînement.
La question utile n’est donc pas « quelle technique est la meilleure ? », mais « quel problème mesuré essaie-t-on de résoudre ? ». Une procédure interne qui change souvent, un format JSON à respecter et un ton rédactionnel cohérent ne sont pas le même besoin. Ce guide propose une grille de décision, une architecture de départ et des étapes d’évaluation. Les recommandations sont rédigées à partir des documentations et sources consultées le 5 novembre 2026 ; les catalogues de modèles, prix et conditions d’hébergement évoluant rapidement, ils doivent être vérifiés au moment du projet.
Les deux approches ne modifient pas la même partie du système
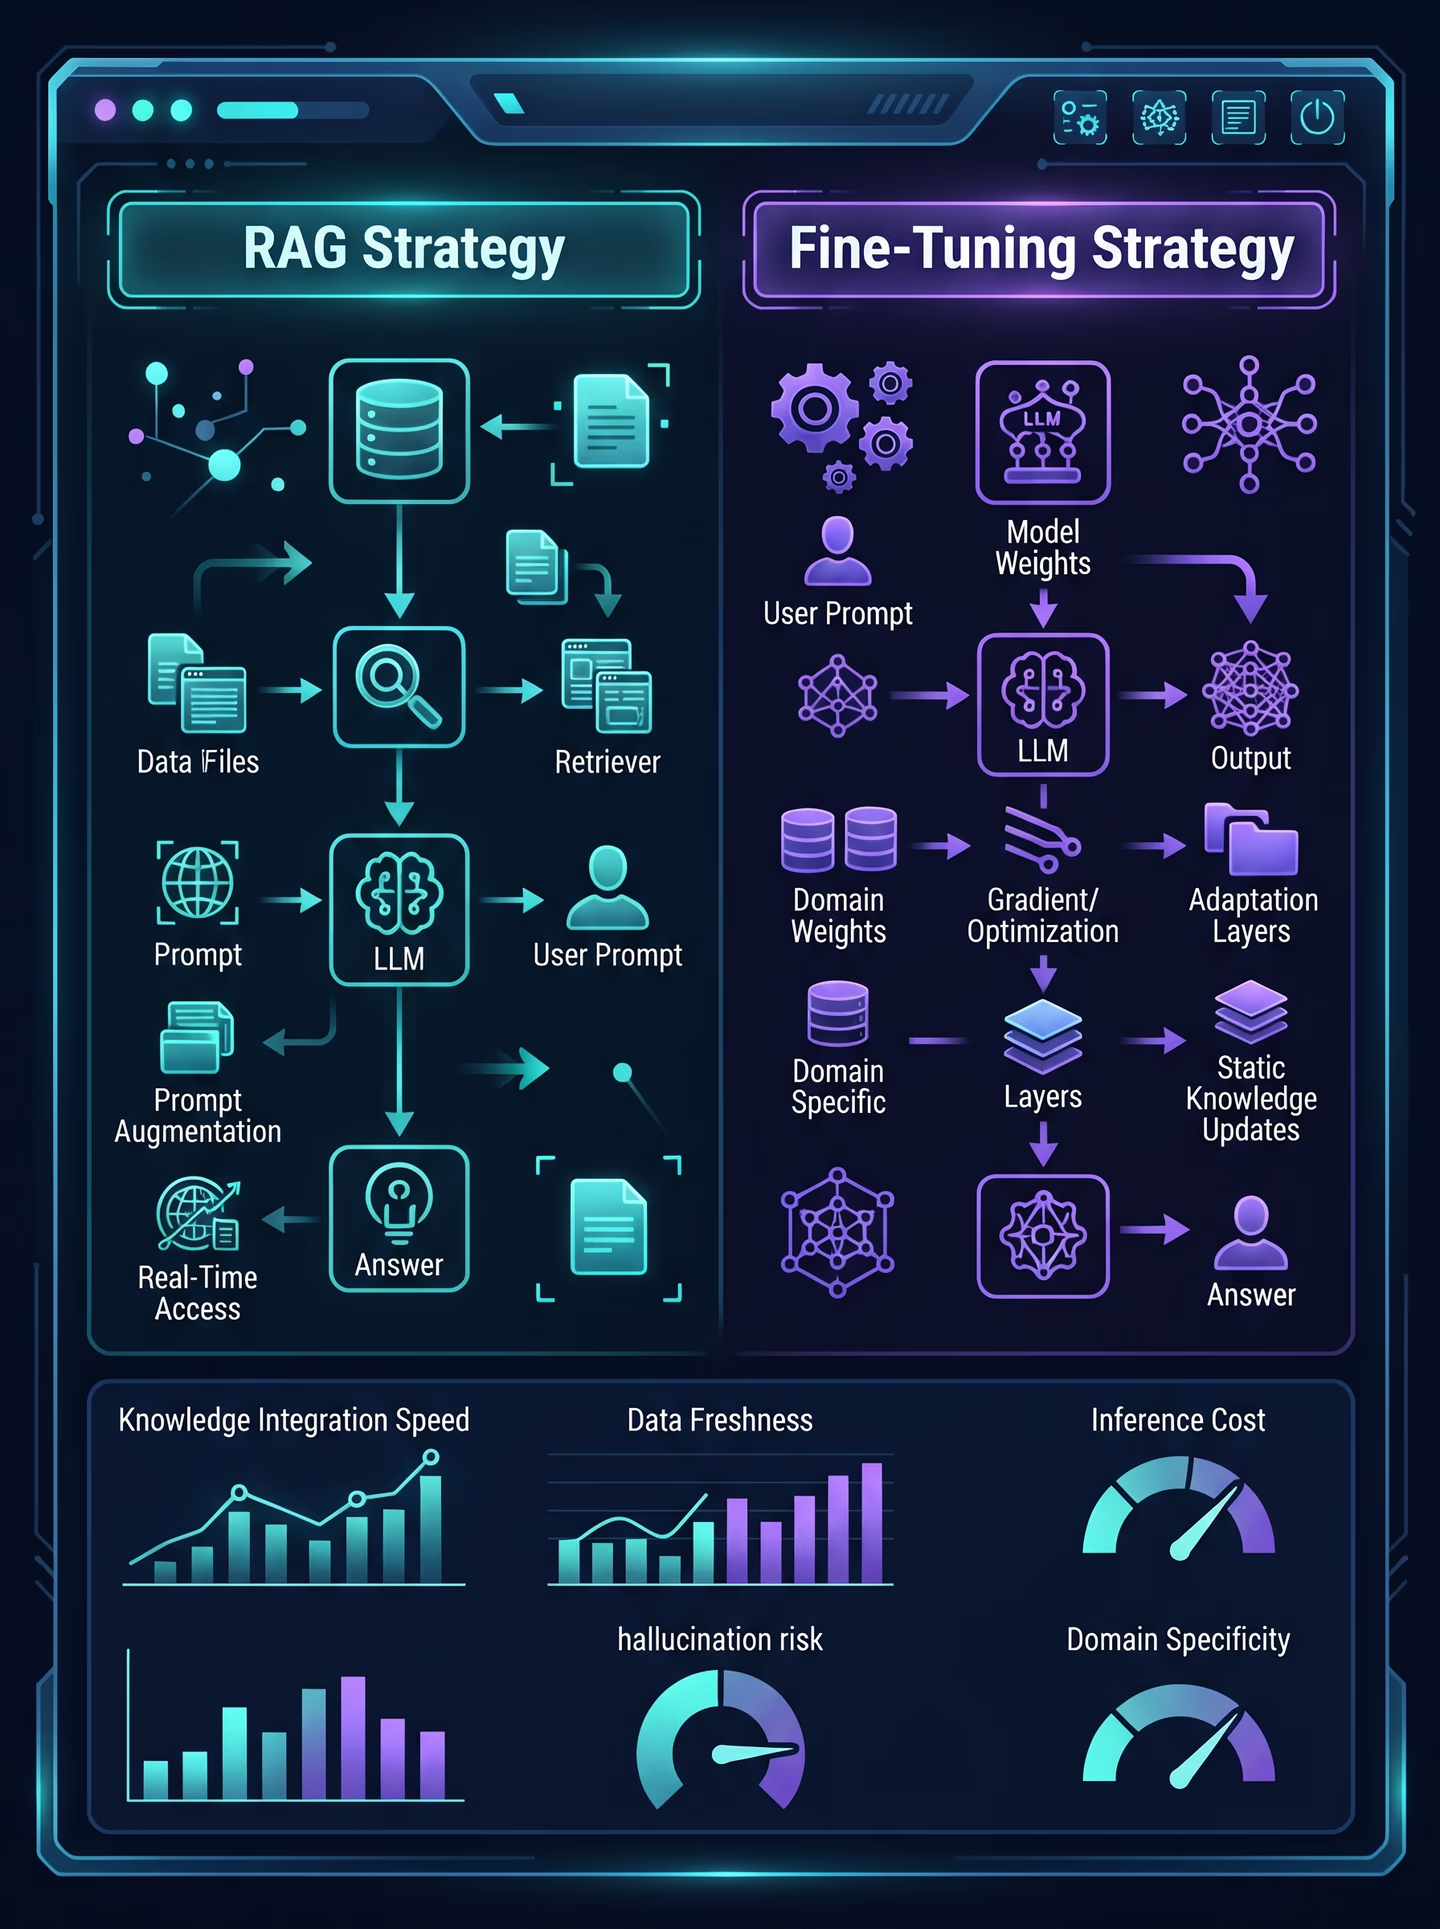
Un modèle pré-entraîné sait produire et transformer du langage, mais il ne connaît pas automatiquement les règles internes d’une organisation. Deux choix sont souvent confondus : ajouter des connaissances consultables et apprendre au modèle une manière de répondre.
Le RAG récupère des sources avant la génération
Dans un RAG, des documents sont préparés et indexés. Lorsqu’une question arrive, le système la transforme éventuellement, recherche des passages pertinents, les transmet au modèle avec des instructions, puis construit une réponse. Cette mémoire documentaire est extérieure aux poids du modèle : changer un document dans le corpus peut rendre une nouvelle version disponible après son ingestion et son indexation.
Le mécanisme s’appuie souvent sur des embeddings, c’est-à-dire des représentations numériques qui permettent de comparer le sens approximatif d’une question et de passages. Une base vectorielle comme Qdrant, ou l’extension pgvector dans PostgreSQL, peut servir à stocker les vecteurs et à effectuer des recherches. Le composant vectoriel ne constitue toutefois qu’une partie du dispositif : qualité des documents, recherche lexicale, filtres, permissions, classement, contexte et consignes influencent aussi le résultat.
La publication fondatrice sur la génération augmentée par récupération décrit l’association d’une mémoire paramétrique (le modèle) et d’une mémoire non paramétrique (des documents récupérés). Pour les usages actuels, cette distinction reste utile : les documents de référence sont consultés et versionnés en dehors du modèle (papier de recherche RAG).
Le fine-tuning adapte des comportements à partir d’exemples
Le fine-tuning reprend un modèle existant et l’entraîne sur un jeu d’exemples choisis pour améliorer une tâche ou un comportement : classer des demandes, produire un format régulier, employer un vocabulaire, respecter un style ou suivre une procédure de réponse. L’information apprise est distribuée dans les paramètres adaptés ; on ne peut pas demander au modèle de pointer simplement vers la ligne de données d’origine comme on le ferait avec un document récupéré.
Le fine-tuning supervisé n’est pas la seule forme d’adaptation, et ses résultats dépendent du modèle de départ, de la qualité des exemples, des paramètres d’entraînement et de l’évaluation. LoRA permet d’entraîner des paramètres additionnels sans mettre à jour tous les poids du modèle. QLoRA combine cette approche avec une quantification du modèle de base. La documentation de PEFT et de son intégration à TRL présente ces options et leurs conditions d’usage.
Un jeu d’exemples composé de rapports bien rédigés peut aider à reproduire une structure ou un ton. Il ne transforme pas le fine-tuning en moteur de recherche exact. Si un prix, un contrat ou une procédure doit rester à jour et être justifié par sa version source, une mise à jour des poids est peu pratique comme mécanisme de publication de la vérité métier.
Le bon critère : la nature de l’information à apprendre
Avant de choisir un outil, classez le besoin dans une ou plusieurs catégories.
| Besoin observé | Première approche à évaluer | Pourquoi |
|---|---|---|
| Répondre à partir de documents qui changent | RAG | Le corpus peut être mis à jour sans réentraîner le modèle. |
| Afficher les passages et les sources utilisées | RAG | Les résultats peuvent porter des identifiants de document et de passage vérifiables. |
| Suivre un ton, une structure ou un format stable | Prompt, puis éventuellement fine-tuning | Les exemples d’entrée et de sortie décrivent le comportement attendu. |
| Reconnaître des catégories métier récurrentes | Évaluer d’abord une règle, un classifieur ou un prompt ; comparer ensuite le fine-tuning | Le modèle n’est pas toujours la solution la plus simple. |
| Filtrer les réponses selon l’utilisateur ou l’organisation | Recherche avec contrôles d’accès, souvent RAG | L’autorisation est une règle applicative ; elle ne doit pas dépendre d’une préférence apprise par le modèle. |
| Améliorer simultanément le style et l’usage de sources récentes | Architecture hybride à tester | Chaque composant peut répondre à un objectif distinct. |
Le volume seul ne tranche pas. Un petit nombre de documents critiques, souvent modifiés et soumis à des permissions peut déjà justifier un RAG. À l’inverse, des milliers d’exemples propres peuvent aider à apprendre une classification ou un format, si ces exemples couvrent bien les cas réels. La question est de savoir si l’information doit être retrouvée et attribuée, ou si le modèle doit reproduire un comportement à partir d’exemples.
Un arbre de décision pour un premier cadrage
- La réponse doit-elle s’appuyer sur des informations qui changent ? Si oui, commencez par rechercher des sources à jour et affichables : RAG, moteur de recherche documentaire ou requête contrôlée vers une base métier.
- La réponse doit-elle citer ou montrer une preuve vérifiable ? Si oui, conservez les identifiants, versions et extraits utilisés. Un modèle adapté par fine-tuning ne crée pas à lui seul cette traçabilité.
- Le problème reste-t-il présent quand les bonnes sources figurent déjà dans le contexte ? Si le modèle ignore une structure attendue, classe mal ou reformule de façon incohérente, testez d’abord des instructions et des exemples ; le fine-tuning devient une hypothèse seulement si l’amélioration est reproductible.
- Le format est-il assez stable pour être appris ? Un contrat de sortie ou une taxonomie changent parfois. S’ils changent fréquemment, des règles applicatives ou un schéma de validation peuvent être plus faciles à maintenir que des poids réentraînés.
- Les deux besoins sont-ils réels ? Essayez une architecture hybride sur un jeu de test : adaptation du comportement d’un côté, récupération d’informations de l’autre. Comparez-la aux solutions simples avant de conserver les deux.
- Les contraintes de données permettent-elles l’approche ? Cartographiez les documents, les personnes autorisées, les journaux et les services externes. Si les conditions de traitement sont inconnues, le choix technique est prématuré.
Cette séquence évite de commencer par l’entraînement parce qu’il paraît plus spécialisé, ou par une base vectorielle parce qu’elle est disponible. Un prompt mieux formulé, des règles métier explicites, une recherche plein texte ou une requête SQL peuvent suffire. Le guide général sur le RAG détaille les composants de cette architecture.
RAG : ce qu’il apporte et ce qu’il ne garantit pas
Le principal avantage opérationnel du RAG est la séparation entre les connaissances publiées et le comportement du modèle. Une équipe peut corriger un document, retirer une version obsolète et reconstruire l’index sans entraîner les paramètres du LLM. Les références retournées donnent un point de contrôle utile aux utilisateurs et aux évaluateurs.
Cette capacité ne signifie pas qu’un RAG élimine les erreurs. Le bon document peut ne pas être trouvé ; la découpe peut séparer une règle de son exception ; les résultats peuvent contenir deux versions incompatibles ; le modèle peut extrapoler au-delà des extraits. Une citation affichée n’est pas une preuve si elle ne soutient pas réellement la phrase associée. Il faut évaluer séparément le rappel des passages, leur classement, la fidélité de la réponse et la capacité à dire « je ne sais pas ».
La recherche vectorielle n’est pas toujours la seule recherche utile. Les requêtes comportant des références exactes, numéros de contrat, codes produits ou acronymes peuvent nécessiter une recherche lexicale. Les documentations de Qdrant sur les requêtes hybrides décrivent la combinaison de vecteurs denses, de vecteurs clairsemés et de recherche texte. Cette combinaison ajoute des index et du travail de requête : elle doit donc être comparée sur des cas réels. Dans PostgreSQL, pgvector permet de conserver les vecteurs avec les données relationnelles ; ses index approximatifs et les filtres SQL ont aussi des compromis de rappel et de performance à mesurer.
Le choix entre base vectorielle spécialisée et extension de base relationnelle dépend de l’exploitation, des permissions, du volume, des requêtes et des compétences de l’équipe. Aucun produit ne supprime le besoin d’une stratégie de sauvegarde, d’une surveillance de la qualité de recherche et d’une procédure de réindexation.
Fine-tuning : quand l’adaptation vaut son coût
Le fine-tuning est pertinent lorsque le système échoue de manière répétée sur un comportement que des exemples peuvent décrire. Cela peut être la production d’un format précis, la catégorisation cohérente d’un type de demande ou l’adoption d’un style spécialisé. Il ne faut pas le juger sur un exemple réussi : il doit améliorer un jeu de contrôle non utilisé lors de l’entraînement, sur les dimensions qui comptent pour le produit.
Un protocole raisonnable commence par un modèle de référence sans adaptation. L’équipe documente les erreurs, prépare et déduplique des exemples autorisés, sépare entraînement et évaluation, puis compare le modèle adapté au même jeu de contrôle. Les exemples doivent représenter les variations et cas limites, pas uniquement les réponses idéales les plus faciles. Les changements de modèle, de tokenizer, de format de conversation ou d’API peuvent nécessiter une nouvelle vérification.
LoRA et QLoRA réduisent certains coûts de calcul par rapport à l’ajustement complet des paramètres, mais ne rendent pas le projet gratuit ou sans exploitation. Il faut conserver le modèle de base compatible, les adaptateurs, les jeux d’entraînement, les versions logicielles et la procédure de déploiement. Les adaptateurs eux-mêmes peuvent révéler des caractéristiques des données d’entraînement ; ils doivent donc être traités comme des artefacts à protéger.
Ne choisissez pas le fine-tuning uniquement pour éviter de fournir un contexte au modèle. La réduction du prompt doit être mesurée contre le coût d’entraînement, l’hébergement, les mises à jour, le suivi des erreurs et le risque de perdre une capacité générale. Si la tâche peut être réglée par un prompt, un validateur ou une recherche, comparez d’abord ces solutions moins lourdes.
Architecture hybride : séparer les responsabilités
Une architecture hybride peut être utile lorsque l’organisation demande à la fois des réponses fondées sur des informations actuelles et une présentation constante. Le RAG récupère les documents autorisés et leurs passages ; le modèle produit une réponse au format demandé ; un validateur contrôle la structure et la présence des références. Un modèle fine-tuné peut éventuellement améliorer un comportement récurrent, mais ne doit pas devenir l’unique dépôt d’informations changeantes.
Une chaîne simplifiée ressemble à ceci :
Question et identité de l’utilisateur
        ↓
Vérification des droits et recherche filtrée
        ↓
Classement des passages et contrôle de leur fraîcheur
        ↓
Instructions + passages autorisés + modèle
        ↓
Réponse, références et validation du format
        ↓
Journalisation minimale et retour utilisateur
La vérification d’accès doit intervenir avant que le contexte soit envoyé au modèle. Filtrer seulement l’interface après génération peut déjà exposer le contenu à un composant non autorisé. Stockez les métadonnées de tenant, de classification, de date d’effet et de droits avec chaque document ou passage, puis vérifiez les permissions à chaque recherche. Qdrant documente les payloads et leurs filtres ; cela aide à construire la recherche, mais l’application doit encore définir et tester ses règles d’autorisation.
Préparez également les mises à jour et suppressions : une source retirée doit disparaître du stockage, de l’index, des caches et des sauvegardes selon les règles applicables. Les documents peuvent être recoupés en fragments ; chaque fragment doit conserver sa provenance, sa version et ses permissions. En cas de migration de modèle d’embedding, les vecteurs issus de modèles différents ne sont pas nécessairement comparables : reconstituez et validez l’index avec une procédure de migration.
Calculer le coût total plutôt que comparer deux factures
Un RAG comporte une phase d’ingestion (nettoyage, segmentation, embeddings, indexation), des coûts de stockage et de sauvegarde, une recherche à chaque requête et la génération du modèle. Une solution hybride peut ajouter un reclassement, une recherche lexicale ou un modèle adapté. Les coûts de maintenance comprennent aussi le retrait des sources, les réindexations et les investigations lorsqu’une réponse est contestée.
Le fine-tuning comprend la préparation et la revue des exemples, les essais d’entraînement, le stockage des artefacts, l’hébergement et le suivi des versions. Une méthode paramètre-efficace peut diminuer une partie du calcul, mais la charge d’évaluation et d’exploitation demeure. Les tarifs fournisseurs changent ; les montants globaux trouvés en ligne sont souvent difficiles à comparer si le volume de tokens, le modèle, la qualité attendue et les conditions d’hébergement ne sont pas identiques.
Pour établir une comparaison exploitable, mesurez avec un scénario identique : nombre de questions mensuel, longueur moyenne des entrées et sorties, taille et rythme de mise à jour du corpus, proportion de questions sans réponse, exigences de latence et niveau de revue humaine. Ajoutez le temps d’ingénierie, les sauvegardes, les incidents, les tests de régression et le coût d’un document mal accessible. Une réponse plus rapide mais invérifiable peut coûter davantage à l’organisation qu’une recherche plus lente avec une source claire.
Confidentialité et sécurité : examiner toute la chaîne
Le lieu où tourne le LLM n’est qu’une partie du sujet. Les documents sources, leur extraction, les embeddings, les journaux de requête, les sauvegardes, les outils d’observabilité et les comptes d’administration contiennent parfois des informations sensibles. Un vecteur n’est pas automatiquement anonyme au seul motif qu’il ne ressemble plus au texte lisible.
Avant un pilote, déterminez les catégories de données nécessaires, les personnes autorisées, les finalités, la durée de conservation et les transferts éventuels. Vérifiez les conditions du fournisseur et de l’hébergeur, les options de rétention, les accès support, les régions disponibles et les mécanismes de suppression. L’auto-hébergement donne davantage de contrôle sur certains éléments, mais l’équipe doit aussi sécuriser, mettre à jour, superviser et sauvegarder son infrastructure.
La CNIL invite à examiner les données transmises aux outils d’IA générative et la politique de confidentialité de la solution utilisée (repères CNIL sur l’IA générative et la vie privée). Cette vérification ne remplace pas une analyse adaptée au traitement et aux règles applicables. Pour limiter l’exposition, un prototype peut utiliser des données fictives ou minimisées ; les accès aux sources doivent être testés avec des comptes de droits différents, y compris les cas de retrait d’autorisation.
Évaluer avant de mettre en production
Construisez un jeu de questions avec les équipes qui connaissent le métier. Incluez les formulations réelles, synonymes, fautes, identifiants exacts, demandes multi-documents, documents obsolètes, questions sans réponse et accès refusés. Pour chacune, indiquez les sources attendues, la réponse minimale acceptable et les erreurs les plus graves.
Comparez au moins trois configurations quand elles sont pertinentes : recherche documentaire sans génération, RAG avec modèle générique, puis fine-tuning ou hybride si un problème de comportement demeure. Gardez un jeu de test séparé des exemples utilisés pour ajuster les prompts ou entraîner le modèle. Mesurez la présence des passages utiles, la précision des références, la fidélité de la réponse, les refus appropriés, la latence et le coût par scénario.
Les métriques automatiques peuvent accélérer l’analyse, mais elles n’établissent pas à elles seules qu’une réponse est correcte pour le métier. Faites relire les cas importants par des personnes compétentes et conservez les exemples d’erreur dans une suite de régression. Notre guide sur l’évaluation d’un système RAG détaille la construction d’un protocole de test ; la reproductibilité des expériences aide à conserver les versions et conditions de comparaison.
FAQ : choisir entre RAG, fine-tuning et combinaison
Le RAG ou le fine-tuning réduit-il le plus les hallucinations ?
Aucune des deux approches ne garantit l’absence d’erreur. Le RAG peut fournir des passages vérifiables et des références, mais le modèle peut les interpréter de travers ou produire une affirmation non soutenue. Le fine-tuning peut améliorer un comportement sur des cas représentés, sans transformer le modèle en base documentaire. Mesurez les erreurs sur des questions réelles et prévoyez une abstention quand les éléments manquent.
Le fine-tuning peut-il remplacer une base documentaire ?
Il peut aider à apprendre un style, un vocabulaire, un format ou une tâche stable. Il est moins adapté à des faits qui changent souvent, doivent être attribués à une source, retirés ou filtrés selon les droits. Garder ces faits dans un système consultable rend leur correction et leur contrôle plus explicites.
Faut-il une grande quantité de documents pour un RAG ?
Non. Commencez par un corpus limité qui couvre le besoin et les cas sensibles. Vérifiez les formats, les doublons, les versions et les droits avant d’augmenter le volume. La représentativité et la qualité des sources valent davantage qu’un nombre arbitraire de documents.
LoRA et QLoRA sont-ils des modèles ?
Ce sont des méthodes d’adaptation. LoRA entraîne un ensemble plus réduit de paramètres additionnels ; QLoRA combine cette adaptation avec la quantification du modèle de base pendant l’entraînement. Elles peuvent réduire les besoins de calcul, mais exigent toujours des données contrôlées, des évaluations et une stratégie de déploiement.
Peut-on combiner RAG et fine-tuning ?
Oui. Le RAG peut apporter des informations actuelles et leurs sources tandis que le fine-tuning améliore un comportement qui reste insuffisant après réglage du prompt. La combinaison doit être comparée à une solution plus simple, car elle accroît le nombre de composants à maintenir.
Un RAG auto-hébergé garantit-il la confidentialité ?
Non, pas à lui seul. Il faut examiner les documents, les index, les journaux, les sauvegardes, les accès et les flux vers tout service externe. Les exigences dépendent du traitement et des données : documentez-les avant de choisir une architecture.
Conclusion : choisir une hypothèse testable
Pour des connaissances évolutives, sourcées ou soumises à des droits, commencez par une recherche documentaire contrôlée, éventuellement avec génération. Pour un comportement ou un format stable que les prompts ne corrigent pas suffisamment, mesurez l’intérêt d’un fine-tuning paramètre-efficace. Si les deux besoins coexistent, évaluez une architecture hybride sans la considérer comme automatique.
Le bon choix se valide avec des sources réelles, des droits corrects, un jeu de test séparé et un coût total mesuré. Avant d’augmenter le volume ou d’entraîner un modèle, examinez aussi les articles sur le contrôle qualité d’un pipeline de données et sur l’évaluation d’un RAG.